Für KI-Training und -Inferenz im Cloud-Maßstab
Laut OpenAI hat sich die Nachfrage nach Hochleistungsrechnern für das Training von KI/Deep Learning (DL) seit 2013 alle 3,5 Monate verdoppelt und beschleunigt sich mit der wachsenden Größe der Datensätze und der Anzahl der Anwendungen und Dienste, die auf großen Sprachmodellen (LLMs), Computer Vision, Empfehlungssystemen und mehr basieren.
Angesichts der steigenden Nachfrage nach höherer Trainings- und Inferenzleistung, Durchsatz und Kapazität benötigt die Branche speziell entwickelte Systeme, die mehr Effizienz, geringere Kosten, einfache Implementierung, Flexibilität zur Anpassung und Skalierbarkeit von KI-Systemen bieten. KI hat sich zu einer unverzichtbaren Technologie für verschiedenste Bereiche entwickelt, darunter Copiloten, virtuelle Assistenten, Fertigungsautomatisierung, autonomes Fahren und medizinische Bildgebung, um nur einige zu nennen. Supermicro hat eine Partnerschaft mit Intel geschlossen, um Cloud-Scale-Systeme und Rack-Designs mit Intel Gaudi KI-Beschleunigern anzubieten.
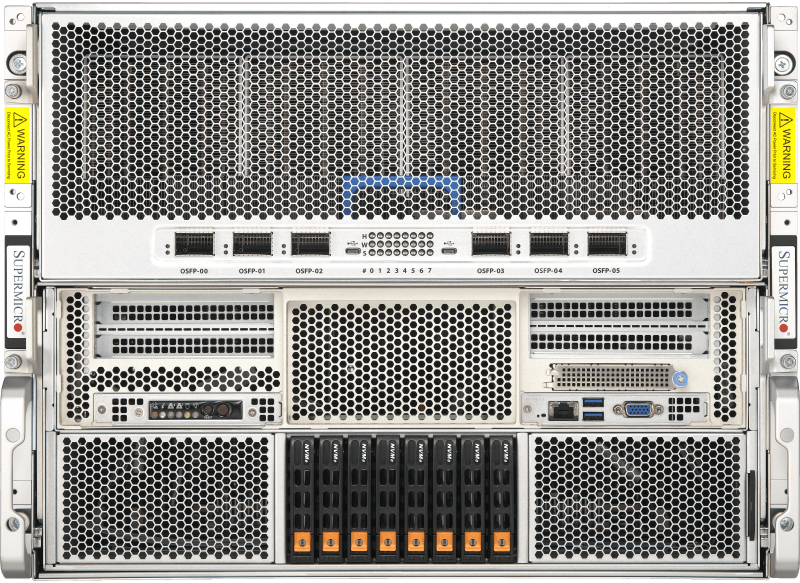
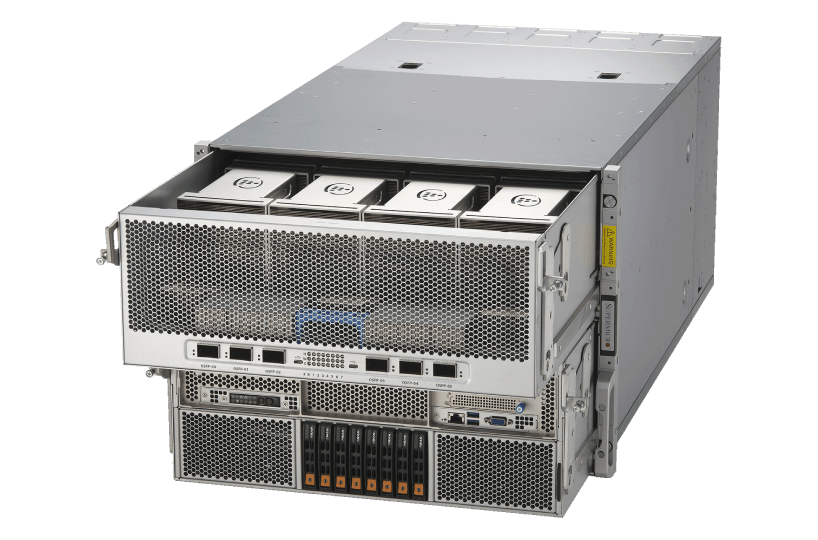
Neu Supermicro X14 Gaudi® 3 KI-Trainings- und Inferenzplattform
Das neue System bietet mehr Auswahlmöglichkeiten auf dem Markt für KI-Unternehmen. Supermicro X14 Die KI-Trainingsplattform basiert auf Intel® Gaudi 3-Beschleunigern der dritten Generation und wurde entwickelt, um die Effizienz des Trainings umfangreicher KI-Modelle sowie der KI-Inferenz weiter zu steigern. Sie ist sowohl in luftgekühlter als auch in flüssigkeitsgekühlter Ausführung erhältlich. Supermicro 'S X14 Die Gaudi 3-Lösung lässt sich problemlos skalieren, um ein breites Spektrum an KI-Workload-Anforderungen zu erfüllen.
- GPU: 8 Gaudi 3 HL-325L (luftgekühlt) oder HL-335 (flüssigkeitsgekühlt) Beschleuniger auf OAM 2.0 Basisplatine
- CPU: Dual Intel® Xeon® 6 Prozessoren
- Speicher: 24 DIMMs – bis zu 6 TB Speicher in 1DPC
- Laufwerke: Bis zu 8 Hot-Swap-fähige Laufwerke PCIe 5.0 NVMe
- Netzteile: 8 x 3000 W hocheffiziente, vollständig redundante (4+4) Titan-Netzteile
- Networking : 6 integrierte OSFP 800GbE-Ports für Scale-Out
- Erweiterungssteckplätze: 2 PCIe 5,0 x 16 (FHHL) + 2 PCIe 5.0 x8 (FHHL)
- Arbeitslasten: KI-Training und -Inferenz
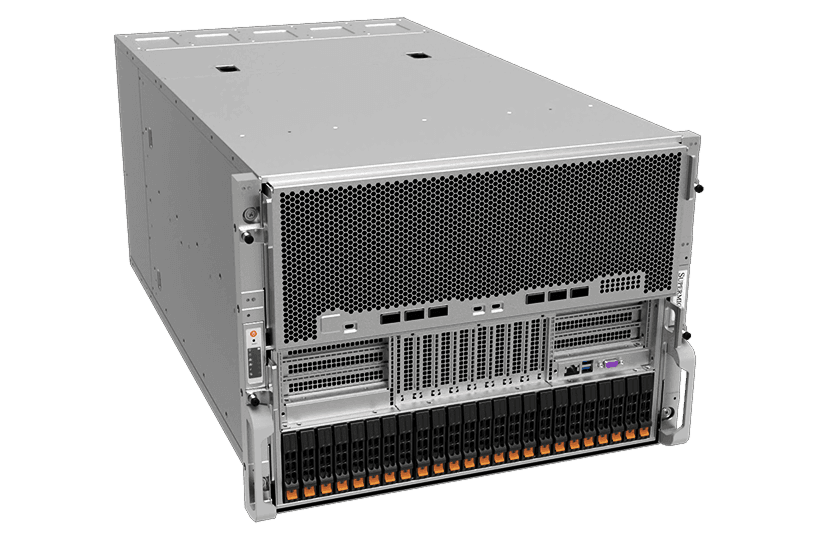
Supermicro Gaudi®2 KI-Trainingsserver
Aufbauend auf dem Erfolg des Originals Supermicro Das Gaudi AI-Trainingssystem, der Gaudi 2 AI-Server, legt Wert auf zwei Hauptaspekte: die Integration von KI-Beschleunigern mit integrierten Hochgeschwindigkeitsnetzwerkmodulen, um die Betriebseffizienz beim Training modernster KI-Modelle zu steigern und der KI-Branche die benötigte Wahlmöglichkeit zu bieten.
- GPU: 8 Gaudi2 HL-225H Mezzanine-Karten
- CPU: Dual-Prozessor der 3. Generation von Intel® Xeon® Skalierbare Prozessoren
- Speicher: 32 DIMMs – bis zu 8 TB registrierter ECC DDR4-3200 MHz SDRAM
- Laufwerke: bis zu 24 Hot-Swap-Laufwerke ( SATA / NVMe / SAS )
- Leistung: 6 x 3000 W hocheffiziente (54 V + 12 V) vollständig redundante Netzteile
- Networking : 24 x 100GbE (48 x 56Gb) PAM4 SerDes-Verbindungen über 6 QSFP-DDs
- Erweiterungssteckplätze: 2x PCIe 4.0-Schalter
- Arbeitslasten: KI-Training und -Inferenz
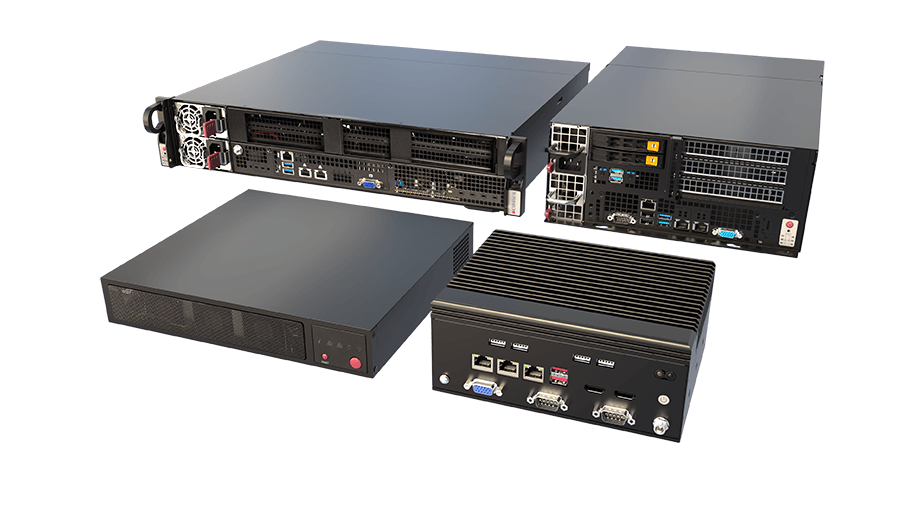
Supermicro Server mit Intel® Gaudi® 3 ist für reale KI-Szenarien optimiert.
Lesen Sie die Produktbeschreibung.
Supermicro X14 Intel® Gaudi® Referenzdesign für KI-Beschleunigercluster
Lesen Sie die Produktbeschreibung.
Supermicro Mit GAUDI 3 AI wird skalierbare Leistung für KI-Anforderungen bereitgestellt.
Lesen Sie das Weißbuch
Supermicro und Intel GAUDI 3 Systems Advanced Enterprise AI Infrastructure
Lesen Sie die Produktbeschreibung.
Supermicro X13 Hyper Ermöglicht KI-Workloads für Unternehmen auf der VMware-Plattform
Lesen Sie die Lösungsübersicht
Beschleunigung von KI-Rechenleistungen mit Supermicro Server in der INTEL® Developer Cloud
Lesen Sie die Erfolgsgeschichte
Überlegene Lösung für Medienverarbeitung und -bereitstellung basierend auf Supermicro Server mit Intel® Data Center GPU Flex-Serie
Lesen Sie die Lösungsübersicht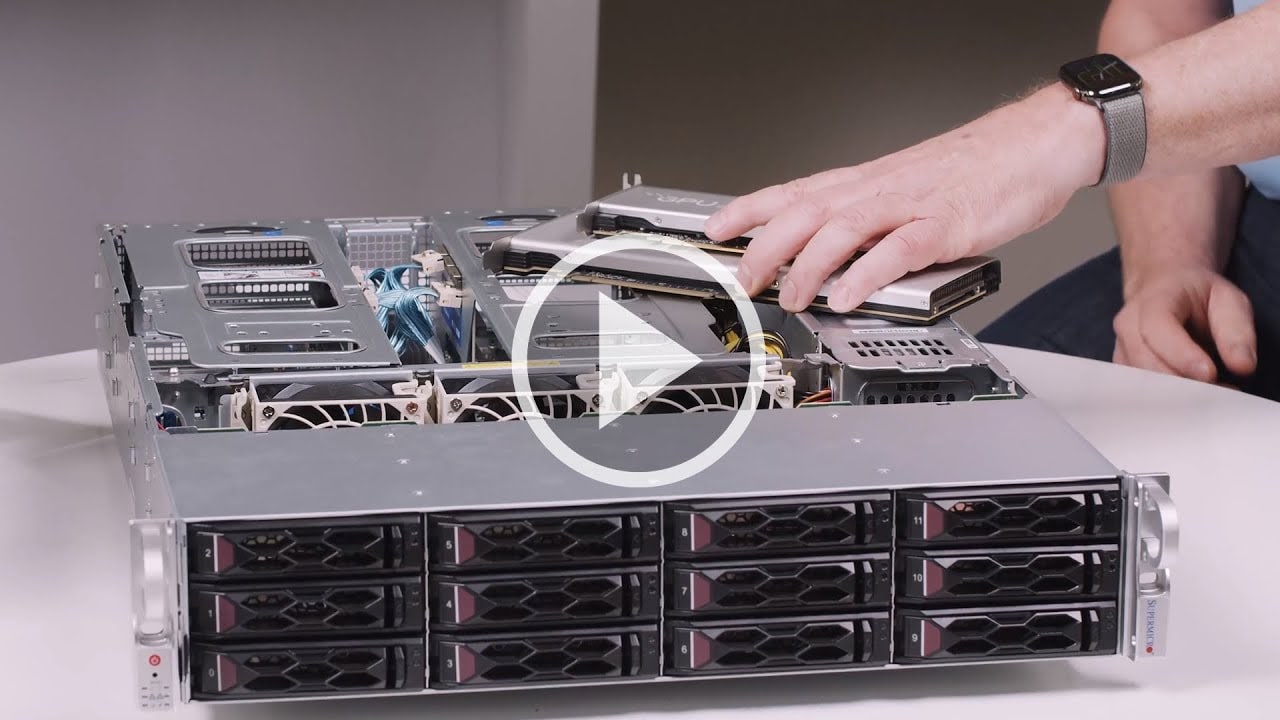
Supermicro TECHTalk: Neue Lösungen für die Medienverarbeitung basierend auf der Intel Data Center GPU Flex-Serie
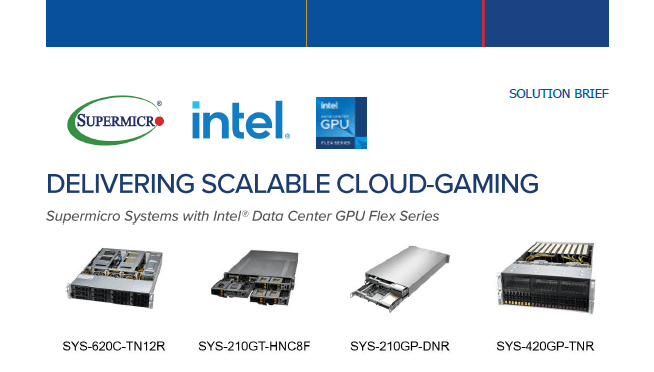
Bereitstellung skalierbarer Cloud-Gaming-Lösungen
Lesen Sie die Lösungsübersicht
Innovative Lösungen für Cloud-Gaming, Medien, Transkodierung und KI-Inferenz
Das Webinar ansehen