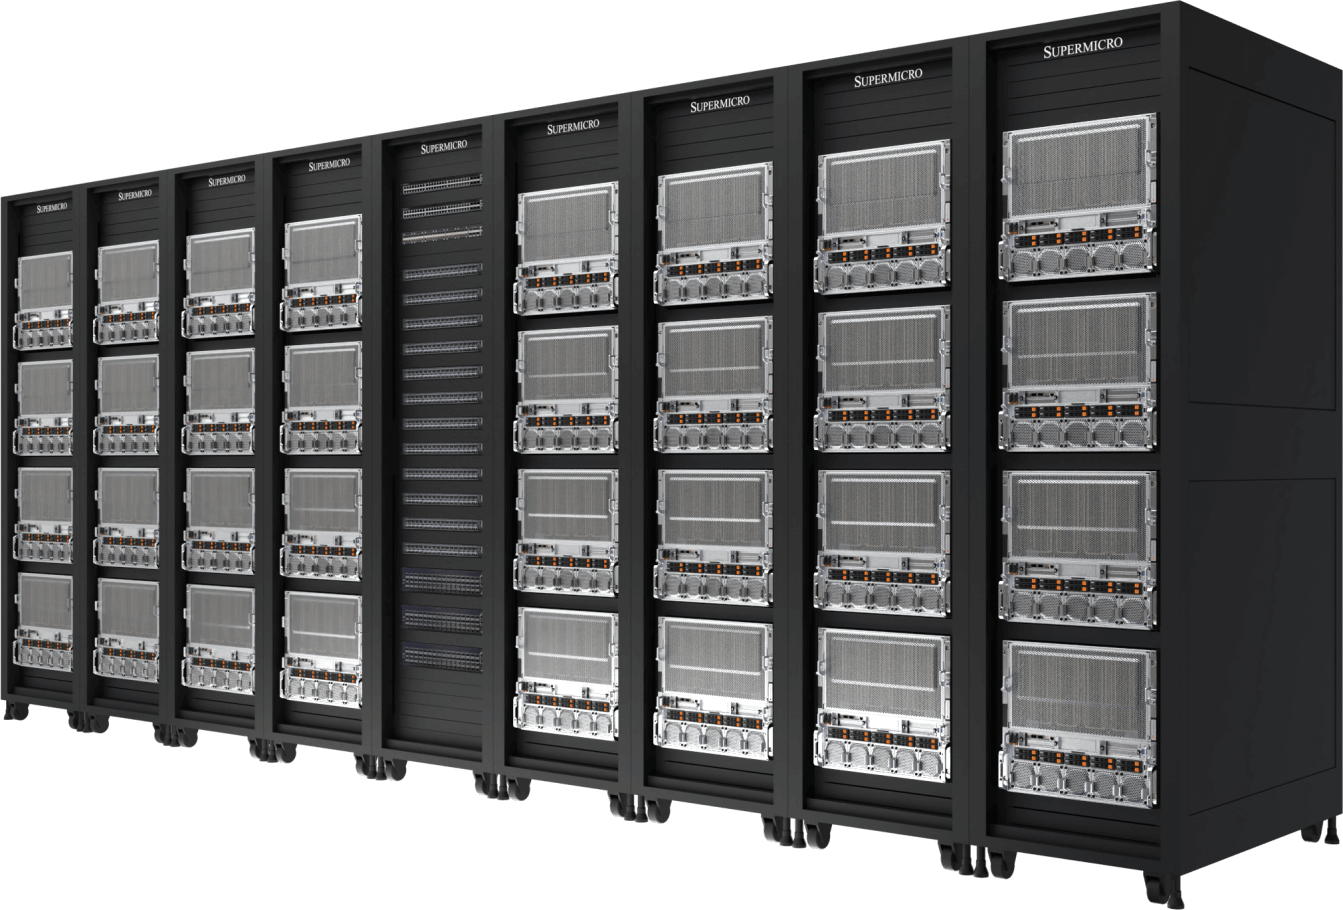
の時代にAIコンピューティングの単位は、もはやサーバーの数だけで測られるものではありません。相互接続されたGPU、CPU、メモリーストレージ、そしてこれらのリソースがラック内の複数のノードに分散配置され、今日の人工知能を構築しています。このインフラストラクチャには、高速かつ低遅延のネットワークファブリック、そして各データセンター環境において最適なパフォーマンスと効率性を維持するために綿密に設計された冷却技術と電力供給システムが不可欠です。 SupermicroのSuperClusterソリューションはエンドツーエンドのAI 急速に進化するデータセンターソリューション生成AI および大規模言語モデル(LLM)。
完全な統合を大規模に
グローバル製造能力により、月間最大 5,000 ラック 規模でフルラックおよびクラスターの設計・構築が可能

オンサイトサービスによるテスト、検証、展開
実績あるL11、L12テストプロセスにより、出荷前に運用効果と効率性を徹底的に検証

液冷/空冷
GPUおよびCPU用コールドプレート、冷却分配ユニット(CDU)、マニホールドを備えた液冷または空冷ソリューションを一体化

供給および在庫管理
ワンストップショップで完全統合型ラックを迅速かつ納期通りにお届けし、迅速な導入のためのソリューション提供までの時間を短縮

このフルターンキーデータセンターソリューションは、ミッションクリティカルなエンタープライズユースケースの納期を短縮し、大規模クラスター構築の複雑さを解消します。これは以前は、スーパーコンピューティングにおける集中的な設計調整と時間のかかる最適化によってのみ達成可能でした。
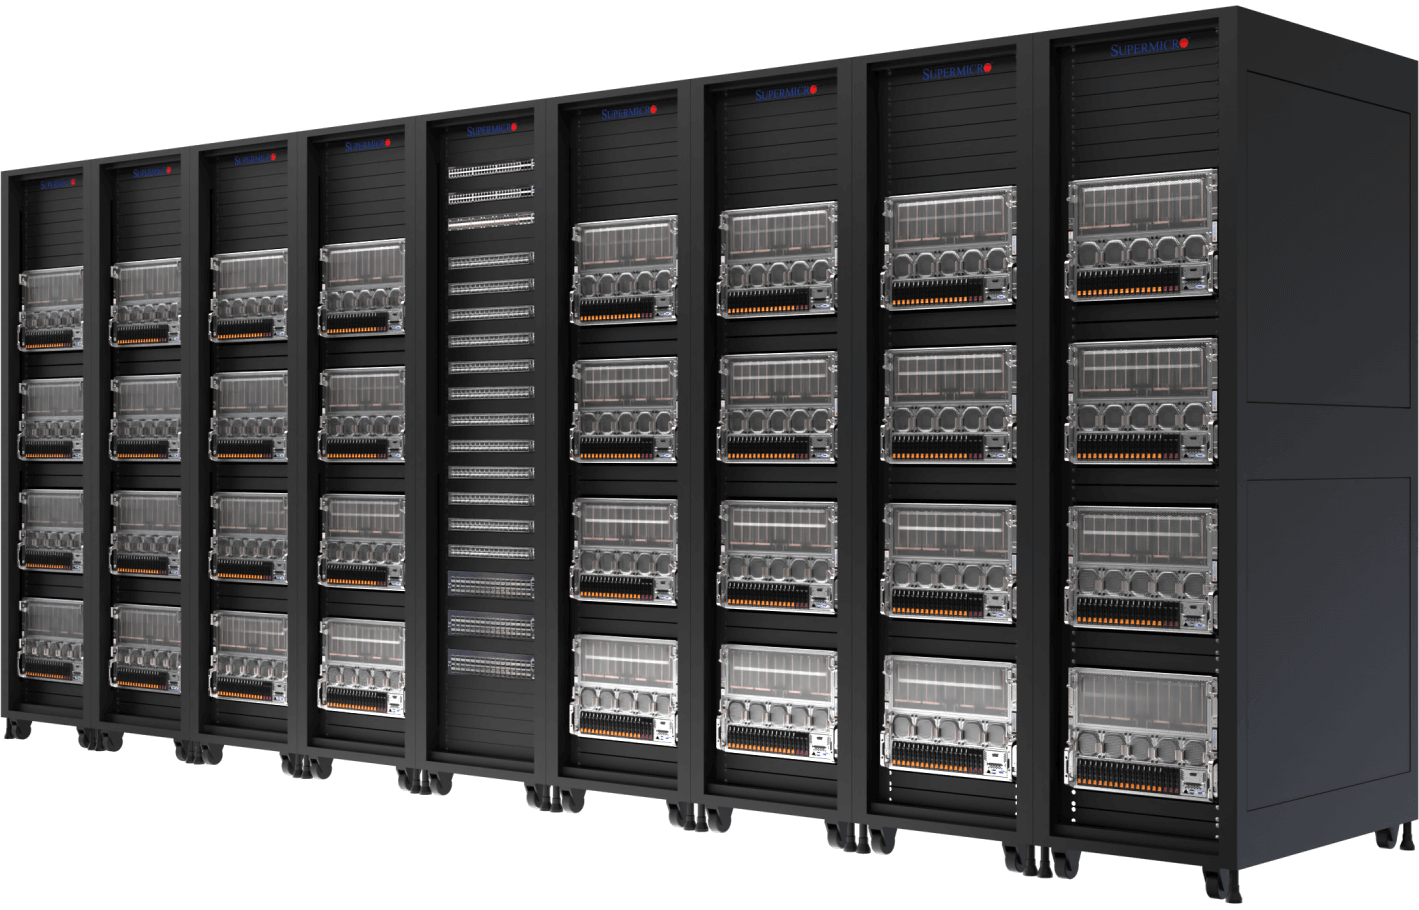
液冷式2OU NVIDIA HGX ™ B300 AIクラスター
最大1152基のNVIDIA B300 GPUを搭載した、完全に統合された液冷144ノードクラスター
- 比類なきAI トレーニング NVIDIA HGX B300によるパフォーマンス密度と、コンパクトな2OU液冷システムノード
- Supermicro 1.8MW容量のインローCDU(ラック内設置型)を備えた直接液冷方式CDU 利用可能なオプション)
- 大型HBM3e GPUメモリー 容量(288GB*のHBM3e)メモリー GPU あたり)およびシステムメモリー 基礎モデルの設置面積トレーニング
- 超低遅延、高帯域幅のAIファブリック向けに、NVIDIA Quantum-X800 InfiniBandでスケールアウト
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- NVIDIAを完全にサポートするように設計されていますAI NVIDIAを含むソフトウェアプラットフォームAI 企業NVIDIA Run: ai
計算ノード(コンピュート・ノード)
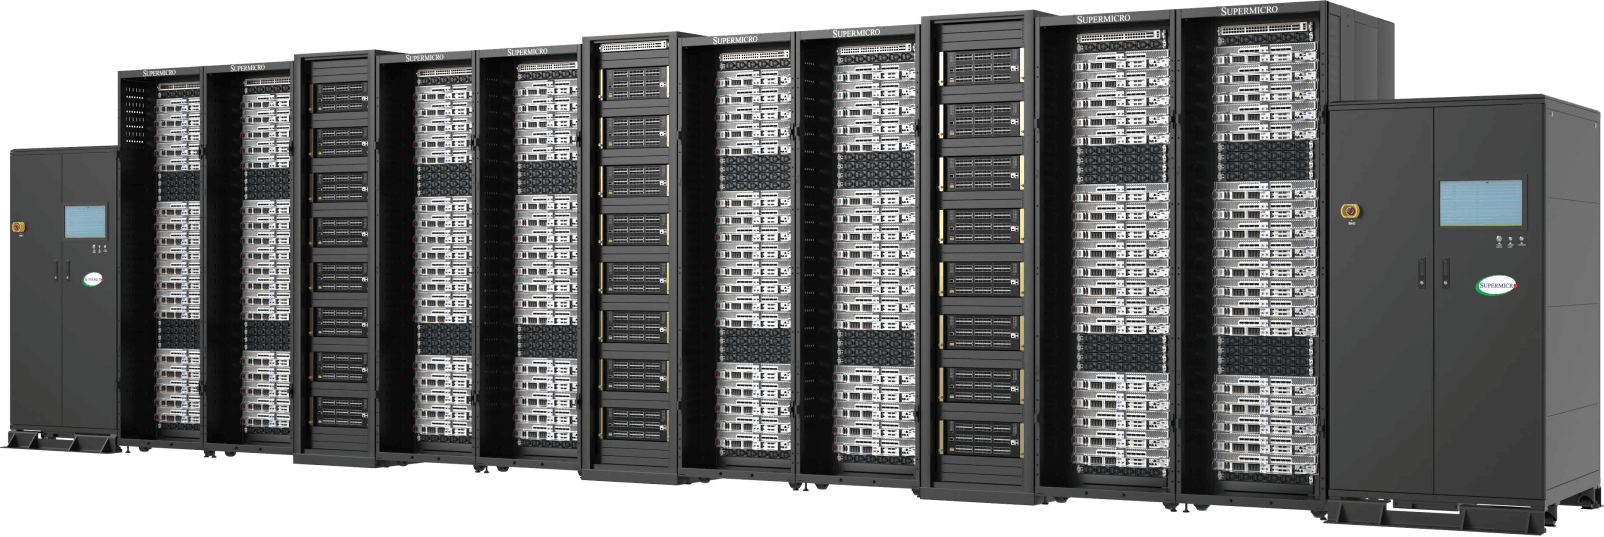
液冷4U NVIDIA HGX B300 AIクラスター
最大576基のNVIDIA B300 GPUを搭載した、完全に統合された液冷72ノードクラスター。
- 展開するハイパフォーマンス AI トレーニング そして推論 NVIDIA HGX B300は、演算密度と保守性を最適化するように設計されています。
- Supermicro 持続的な高出力動作とエネルギー効率の向上を実現する直接液冷方式
- 大型HBM3e GPUメモリー 容量(288GB*のHBM3e)メモリー GPU あたり)およびシステムメモリー 基礎モデルの設置面積トレーニング
- NVIDIA Spectrum™-Xでスケールアウトイーサネット またはNVIDIA Quantum-X800 InfiniBand
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- NVIDIAを完全にサポートするように設計されていますAI NVIDIAを含むソフトウェアプラットフォームAI 企業NVIDIA Run: ai
計算ノード(コンピュート・ノード)


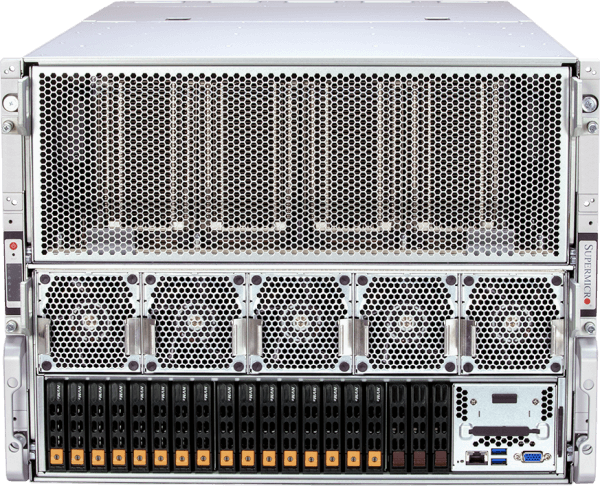
空冷8U NVIDIA HGX B300 AIクラスター
最大256基のNVIDIA HGX B300 GPUと合計73.7TBのHBM3eを搭載した、完全統合型の空冷式32ノードクラスタメモリー
- 参照アーキテクチャに基づくフルスタックソリューションSupermicro システム、NVIDIA GPU、NVIDIAソフトウェア、およびNVIDIAネットワーク
- 最大256基のNVIDIA HGX B300 GPUを搭載し、合計最大73.7TBのHBM3eストレージを提供メモリー (GPUあたり288GBのHBM3e*)
- NVIDIAソフトウェアスタックとの互換性(NVIDIA AI 企業NVIDIA Run: ai )
- システムがラックに完全に統合され、出荷前およびオンサイト展開前にテスト済みのプラグアンドプレイソリューション。
- NVIDIA Spectrum-Xでスケールアウトイーサネット Compute Fabric または NVIDIA Quantum-X800 InfiniBand統合ネットワークおよび帯域外管理を含む
- Supermicro AI 工場NVIDIAが推奨するインフラストラクチャ構成、 Spectrum-Xネットワーキング、およびソフトウェアリファレンススタックに関するソリューションは、NVIDIA Enterprise Reference Architecture for HGX B300に基づいています。
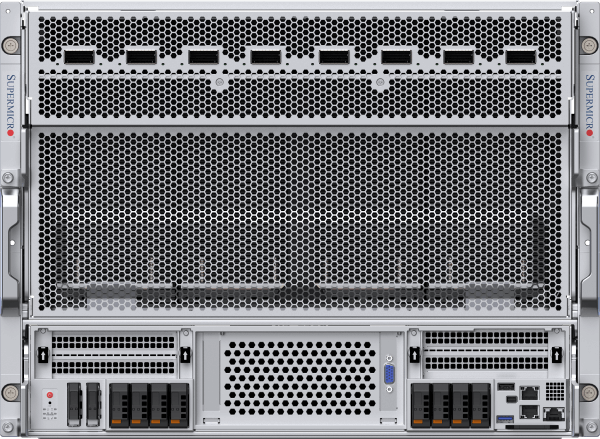
計算ノード(コンピュート・ノード)

液冷NVIDIA HGX B200 AIクラスター
5ラックに設置された、最大32基のNVIDIA HGX B200 8-GPU、4U液冷システム(256基のGPU)。
- 最高峰を展開するAI トレーニング そして推論 1つの拡張可能なユニット(5ラック)に256個のNVIDIA B200 GPUを搭載した場合のパフォーマンス
- Supermicro 250kW容量のラック内冷却液分配ユニットを備えた直接液体冷却( CDU冗長電源ユニットとデュアルホットスワップポンプを搭載
- 45 TBのHBM3eメモリー 拡張可能な1つのユニット
- 400Gb/sのNVIDIA Spectrum-Xでスケールアウトイーサネット またはNVIDIA Quantum-2 InfiniBand
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- NVIDIAを完全にサポートするように設計されていますAI NVIDIAを含むソフトウェアプラットフォームAI 企業NVIDIA Run: ai
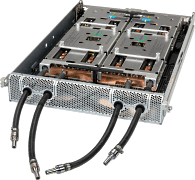
計算ノード(コンピュート・ノード)
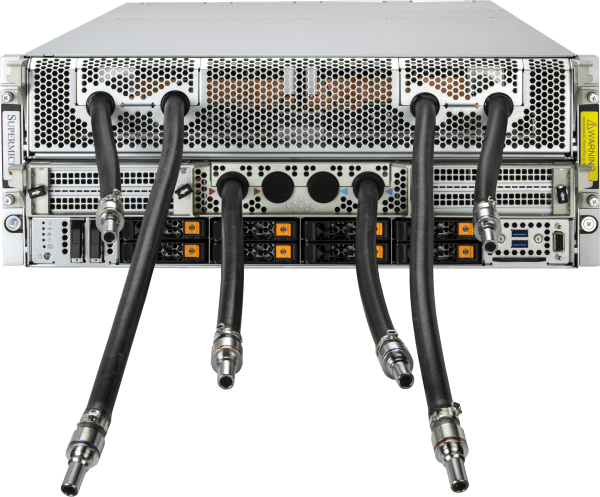
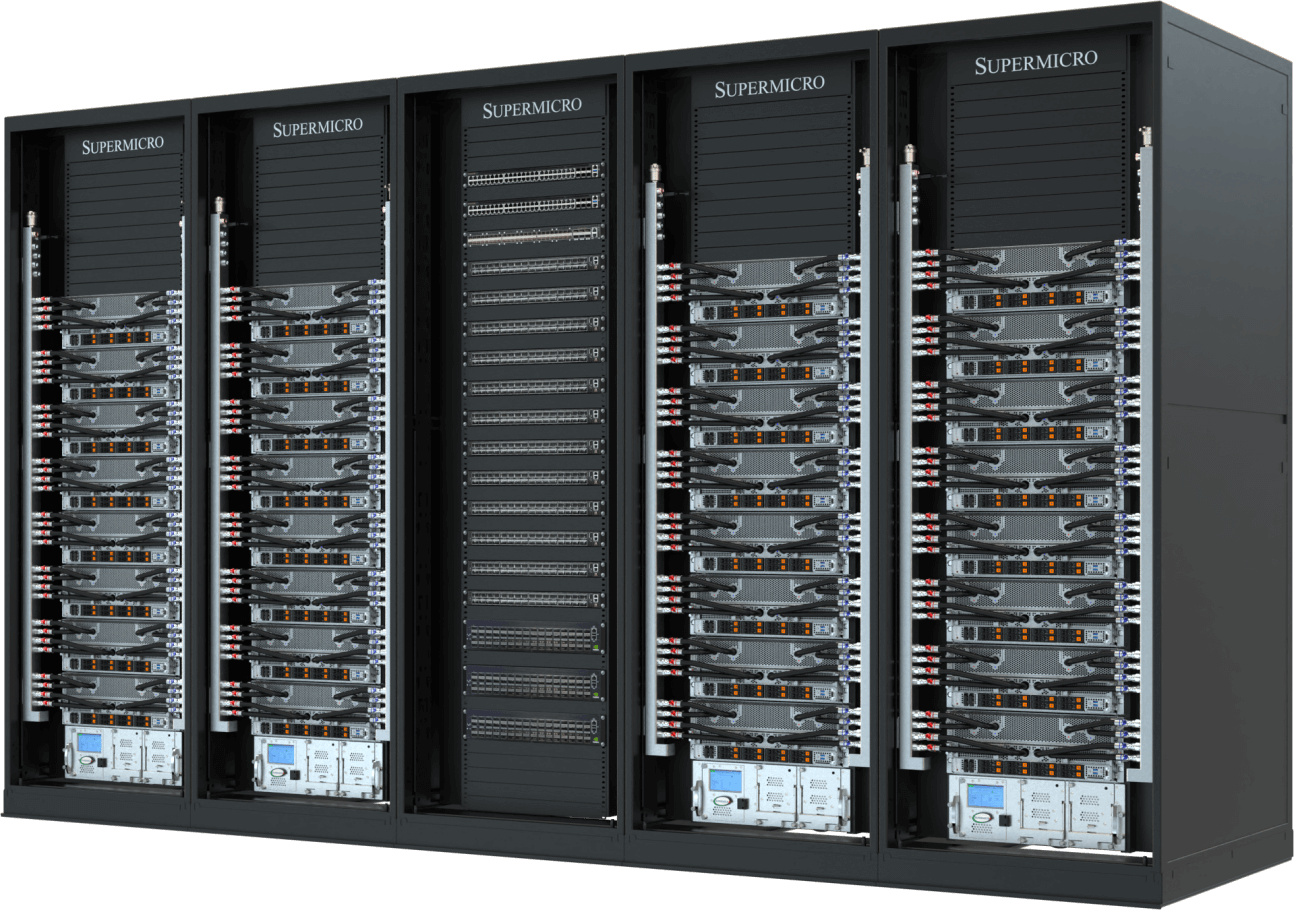
空冷 NVIDIA HGX B200 AI クラスター
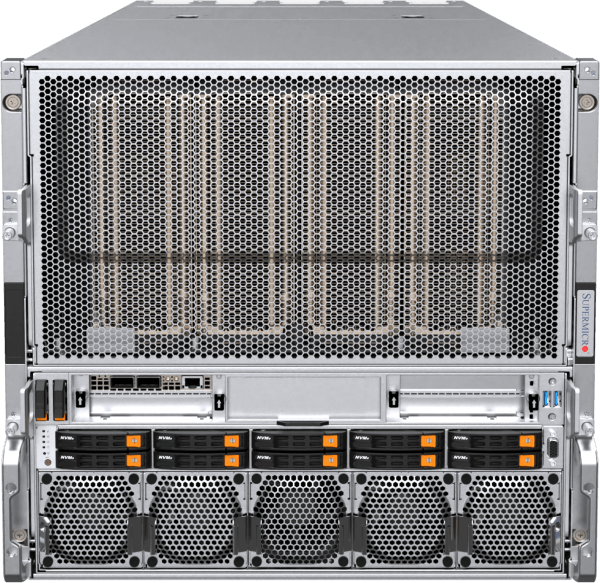
9ラックに32基のNVIDIA HGX B200 8-GPU、10U 空冷システム(256 GPU)を搭載。
- 新しい熱最適化された空冷システムプラットフォームを備えた、実績のある業界をリードするアーキテクチャ。
- 45 TBのHBM3eメモリー 拡張可能な1つのユニット
- 400Gb/s NVIDIA Spectrum-X イーサネットまたは NVIDIA Quantum-2 infiniBandでスケールアウトします。
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- NVIDIA AI Enterprise および NVIDIA Run:ai を含むNVIDIA AI ソフトウェアプラットフォームを完全にサポートする、NVIDIA認定システムノード。
計算ノード(コンピュート・ノード)
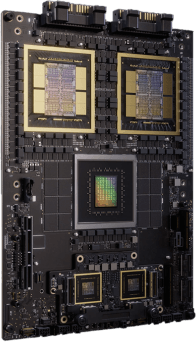
NVIDIA GB300 NVL72
シングルラックでの液冷エクサスケールコンピューティング。
- NVIDIA GB300 Grace™を搭載したラックスケールソリューションBlackwell Superchip社は、NVIDIA B300 GPU 72個と36個のGrace ラックあたりのCPU数
- NVIDIA Blackwell Ultra GPUあたり288GBのHBM3eを搭載
- データセンターの電力コストを最大40%削減するダイレクト液冷。
- コンサルティングから本格的な導入まで、必要なすべての部品、ネットワーキングソリューション、およびオンサイト設置サービスを提供する包括的なサービス。
- 400Gb/s NVIDIA Spectrum-X イーサネットまたは NVIDIA Quantum-2 infiniBandでスケールアウトします。
- 最大800Gb/sのNVIDIA Quantum-2 InfiniBand またはSpectrum-Xイーサネット NVIDIA ConnectX®-8 SuperNICを内蔵
ラックソリューション
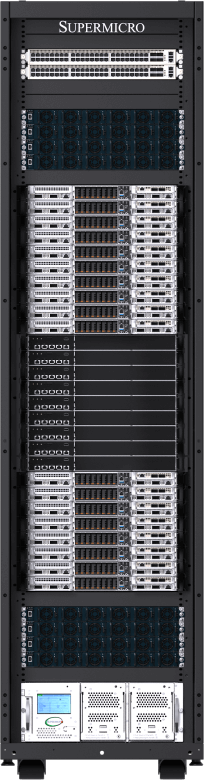
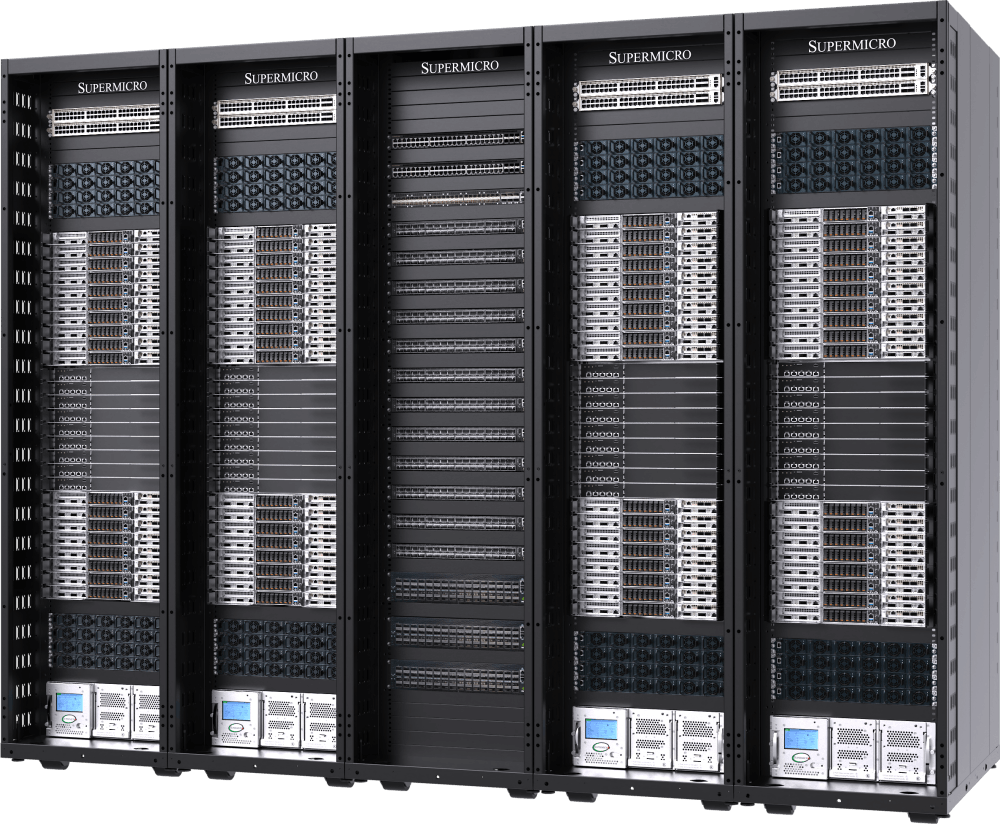
NVIDIA GB200 NVL72
シングルラックでの液冷エクサスケールコンピューティング。
- 72倍NVIDIA Blackwell B200 GPUが、HBM3eの大容量プールを備えた単一のGPUとして動作します。メモリー (ラックあたり13.5TB)
- 9x NVLink Switch、コンピュートトレイあたり4ポートで72基のGPUを接続し、1.8TB/sのGPU間インターコネクトを提供
- Supermicro 250kW容量のラック内冷却液分配ユニットを備えた直接液体冷却( CDU冗長電源ユニットとデュアルホットスワップポンプを搭載
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- 400Gb/s NVIDIA Spectrum-X イーサネットまたは NVIDIA Quantum-2 infiniBandでスケールアウトします。
- NVIDIAを完全にサポートするように設計されていますAI NVIDIAを含むソフトウェアプラットフォームAI 企業NVIDIA Run: ai
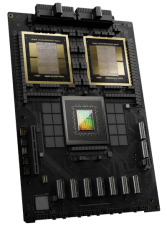
ラックソリューション
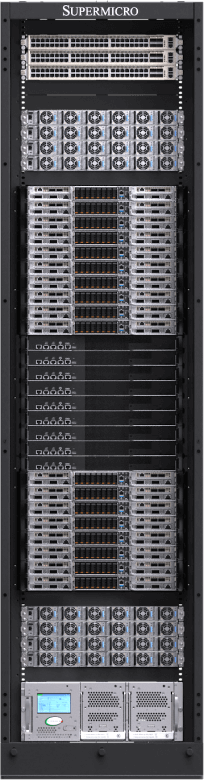
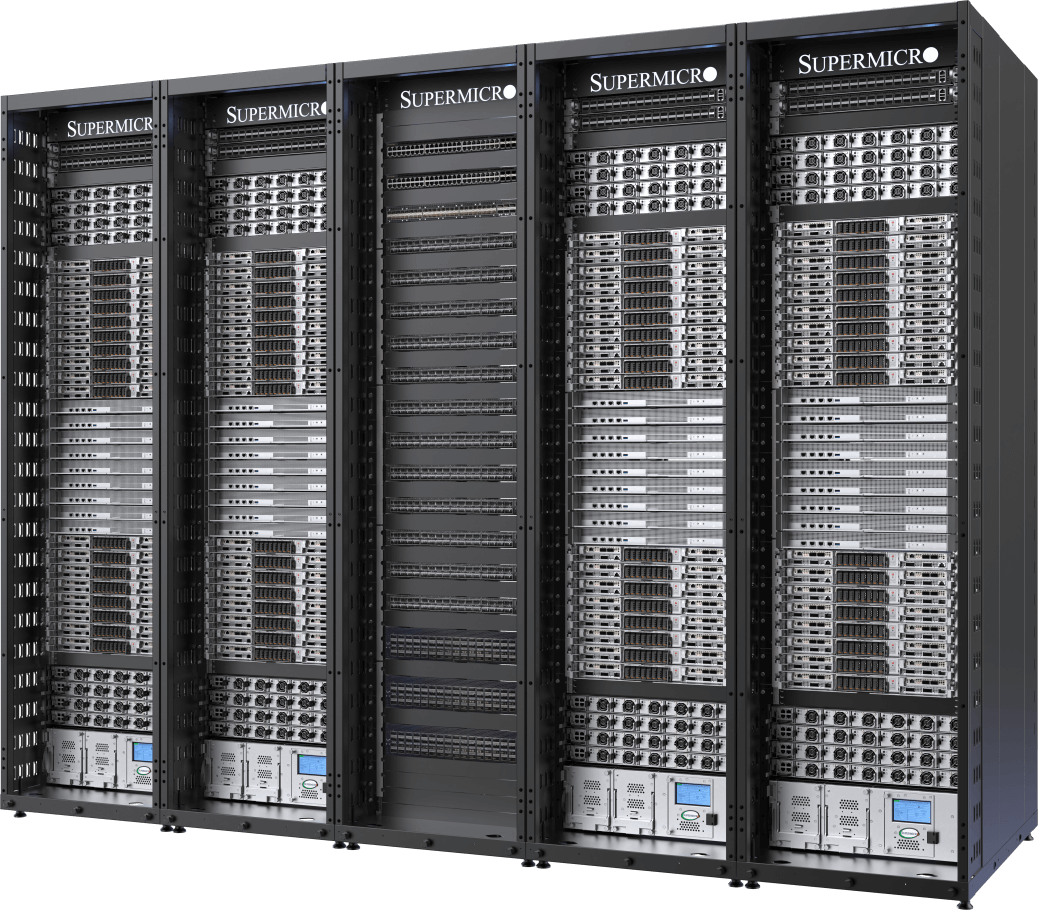
NVIDIA RTX PRO™スーパークラスター
AI 工場NVIDIAによるソリューションRTX PRO 6000 Blackwell サーバーエディション
- 参照アーキテクチャに基づくフルスタックソリューションSupermicro システム、NVIDIA GPU、NVIDIAソフトウェア、およびNVIDIAネットワーク
- 最大256倍のNVIDIA RTX PRO 6000 Blackwell 最大24TBのGDDR7メモリを搭載したサーバーエディションGPUメモリー
- NVIDIAソフトウェアスタックとの互換性(NVIDIA AI 企業NVIDIA Omniverse、NVIDIA Run: ai )
- システムがラックに完全に統合され、出荷前およびオンサイト展開前にテスト済みのプラグアンドプレイソリューション。
- NVIDIA Spectrum-Xイーサネット コンピューティングファブリック、コンバージドネットワーク、アウトオブバンド管理が含まれます
- Supermicro AI 工場NVIDIA エンタープライズ リファレンス アーキテクチャに基づくインフラストラクチャ構成、 Spectrum-Xネットワーク、およびソフトウェア リファレンス スタックに関する NVIDIA が推奨するソリューションRTX PRO 6000 Blackwell サーバーエディション
計算ノード(コンピュート・ノード)
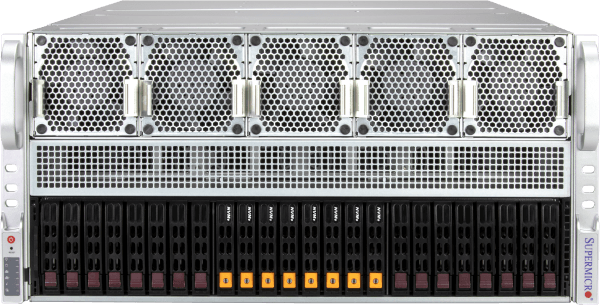

最先端の液冷AIクラスター
32基のNVIDIA HGX H200 8-GPU、4U液冷システム (256基のGPU) を5ラックに搭載
- Supermicroのカスタム液冷ソリューションによりコンピュート密度を2倍にし、データセンターの電力コストを最大40%削減
- 1つのスケーラブルユニットに256基のNVIDIA H200 GPU
- 1つのスケーラブルユニットにH200と36TBのHBM3e
- NVIDIA GPUDirect RDMAおよびStorageまたはRoCEの完全サポート付き専用ストレージファブリックオプション
- 400Gb/s NVIDIA Spectrum-X イーサネットまたは NVIDIA Quantum-2 infiniBandでスケールアウトします。
- NVIDIA AI Enterprise および NVIDIA Run:ai を含むNVIDIA AI ソフトウェアプラットフォームを完全にサポートする、NVIDIA認定システムノード。
計算ノード(コンピュート・ノード)
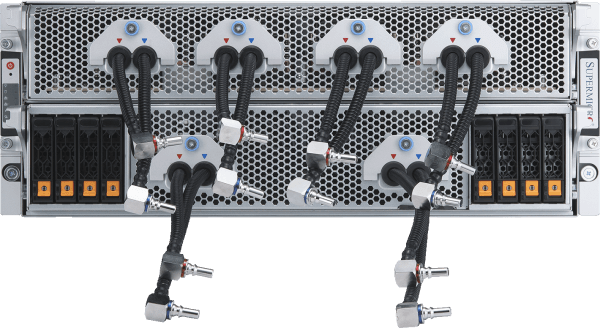
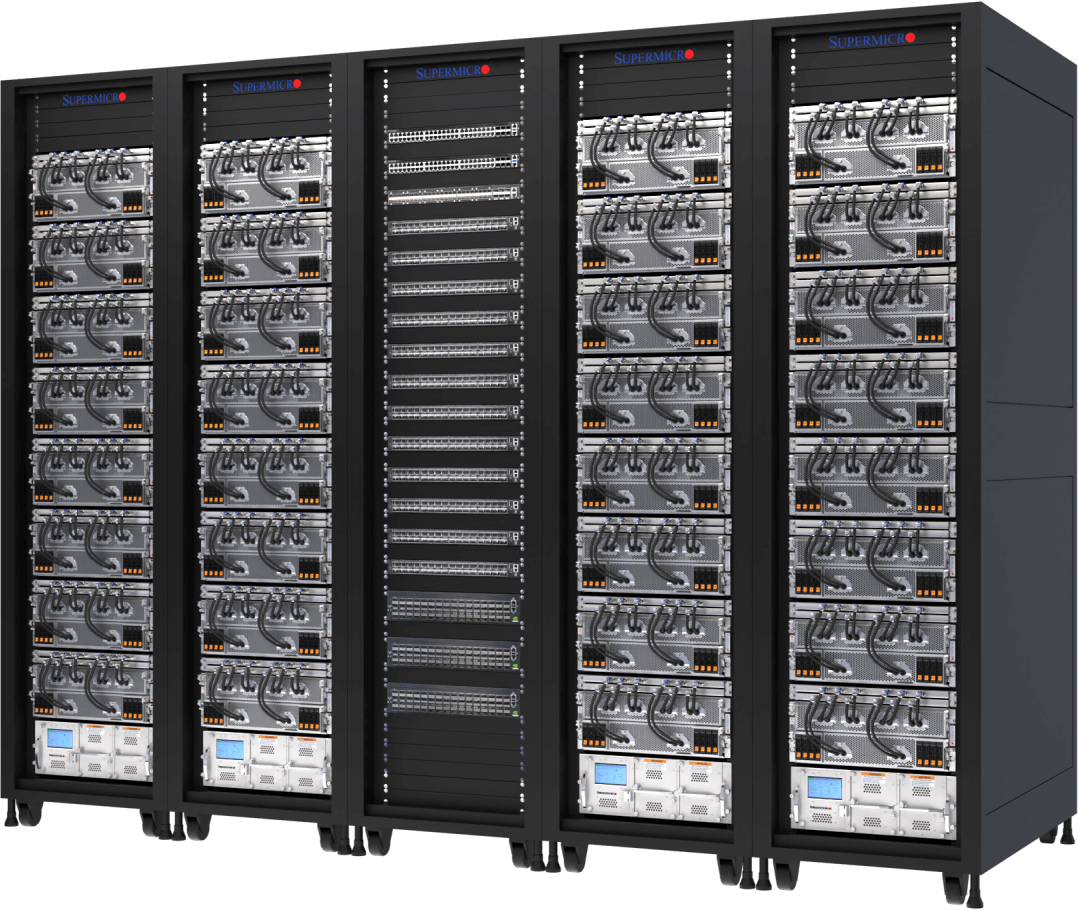
実証済みの設計
9ラックに32台のNVIDIA HGX H200 8-GPU、8U空冷システム(256 GPU)を備え
- 大規模なAIインフラストラクチャ展開向けの実証済みの業界をリードするアーキテクチャ
- 1つのスケーラブルユニットに256基のNVIDIA H200 GPU
- 1つのスケーラブルユニットにH200と36TBのHBM3e
- 400Gb/s NVIDIA Spectrum-X イーサネットまたは NVIDIA Quantum-2 infiniBandでスケールアウトします。
- 業界をリードする並列ファイルシステムオプションを備えた、カスタマイズ可能なAIデータパイプラインストレージファブリック
- NVIDIA AI Enterprise および NVIDIA Run:ai を含むNVIDIA AI ソフトウェアプラットフォームを完全にサポートする、NVIDIA認定システムノード。
計算ノード(コンピュート・ノード)