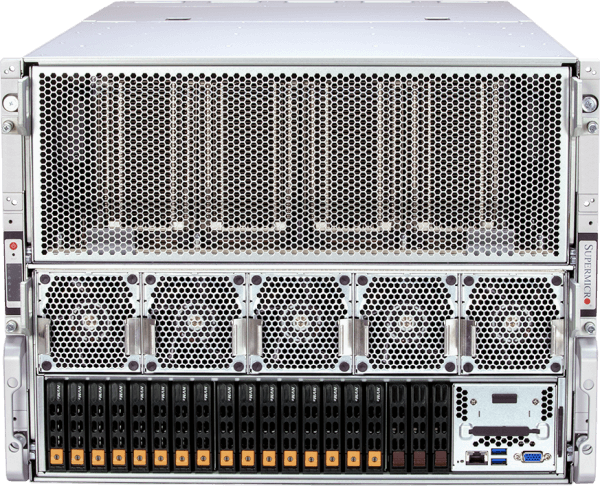
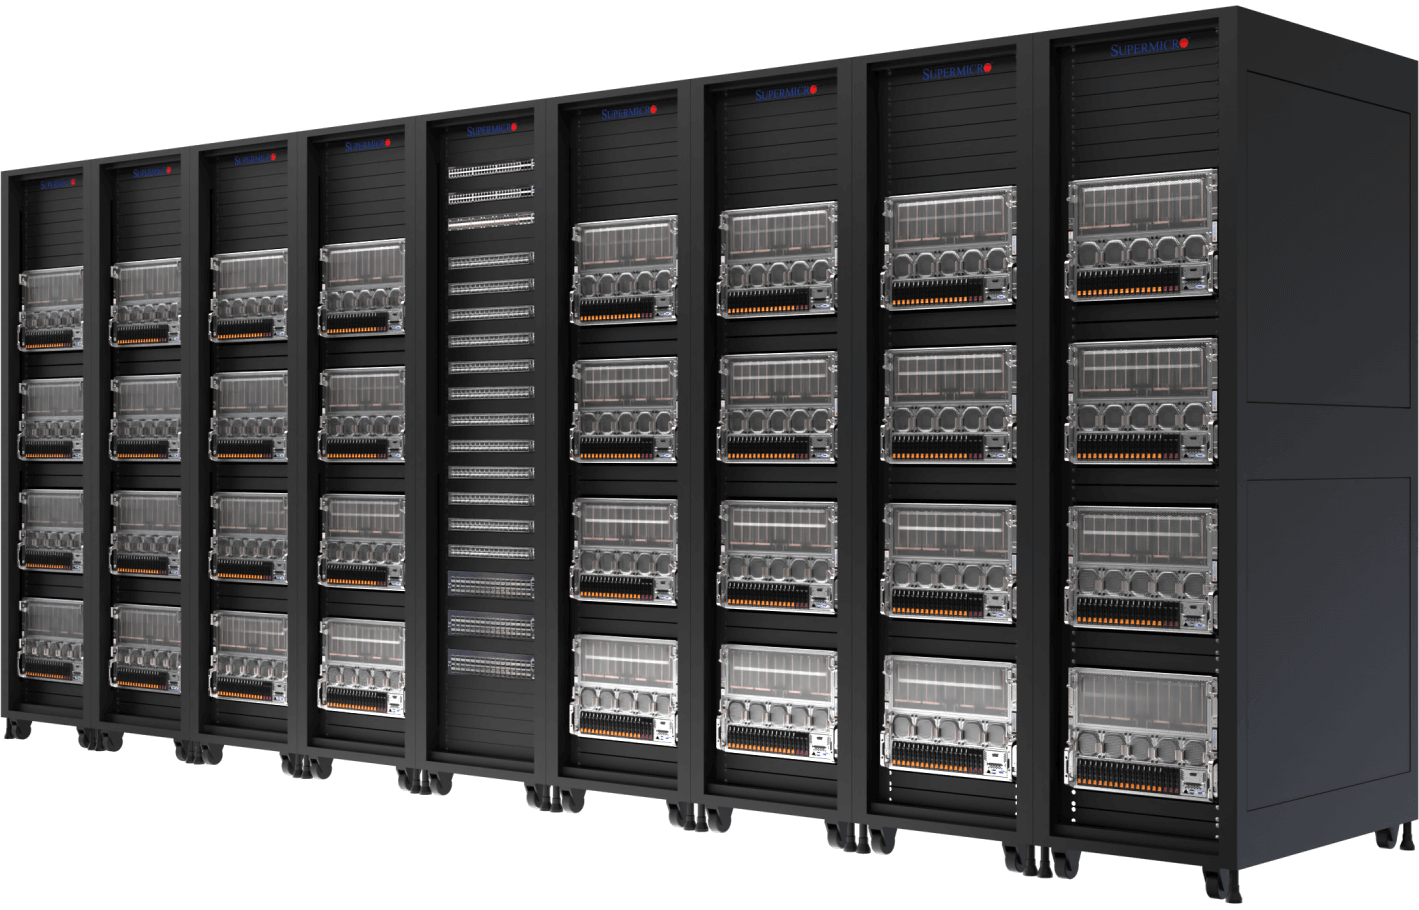
在現今的AI時代,衡量算力的單位不再僅基於伺服器的數量。經互連的GPU、CPU、記憶體、儲存,以及這些機架內多個節點的運算資源,為目前的AI技術奠定了基礎。運算基礎設施需要高速且低延遲的網路結構,以及經精密設計的冷卻技術和電力供應,以維持每個資料中心環境的最佳效能和效率。Supermicro的SuperCluster解決方案可為正快速進步的生成式AI和大型語言模型(LLM)提供端對端AI資料中心解決方案。
完善的大規模式整合
設計並製造完整的機架和叢集,全球製造產能最高可達 5,000 機架 機架/月

透過現場服務進行測試、驗證和部署
L11、L12測試程序可在出貨前針對運作效能與效率進行完整驗證

液冷 / 氣冷技術
包括GPU與CPU冷板、冷卻液分配單元與歧管的完善整合式液冷或氣冷解決方案

供應與庫存管理功能
一站式服務——可快速、及時提供完全整合式機架,加速交付時間,實現快速部署

Supermicro的完善一站式資料中心解決方案可加快關鍵型企業應用的交付時間,並消除叢集建置所產生的複雜性。此前,這些建置程序需要大量的設計調整和耗時的超級運算最佳化作業。
液冷式 2 OU NVIDIA HGX™ B300 AI Cluster
完全整合的液冷式 144 節點叢集,配備高達 1152 個 NVIDIA B300 GPU
- 透過精巧的 2 OU 液冷式系統節點,NVIDIA HGX B300 提供無與倫比的 AI 訓練效能密度
- Supermicro 採用直接液冷技術,配備 1.8MW 容量的機架式 CDU(機架內) CDU 可供選擇的方案)
- 具備龐大的 HBM3e GPU 記憶體容量(每個 GPU 配備 288GB* HBM3e 記憶體)與系統記憶體容量,適用於基礎模型訓練
- 透過 NVIDIA Quantum-X800 InfiniBand 進行規模化擴充,打造超低延遲、高頻寬的 AI 網路架構
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- 旨在全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
計算節點
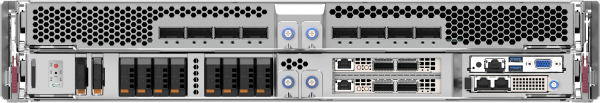
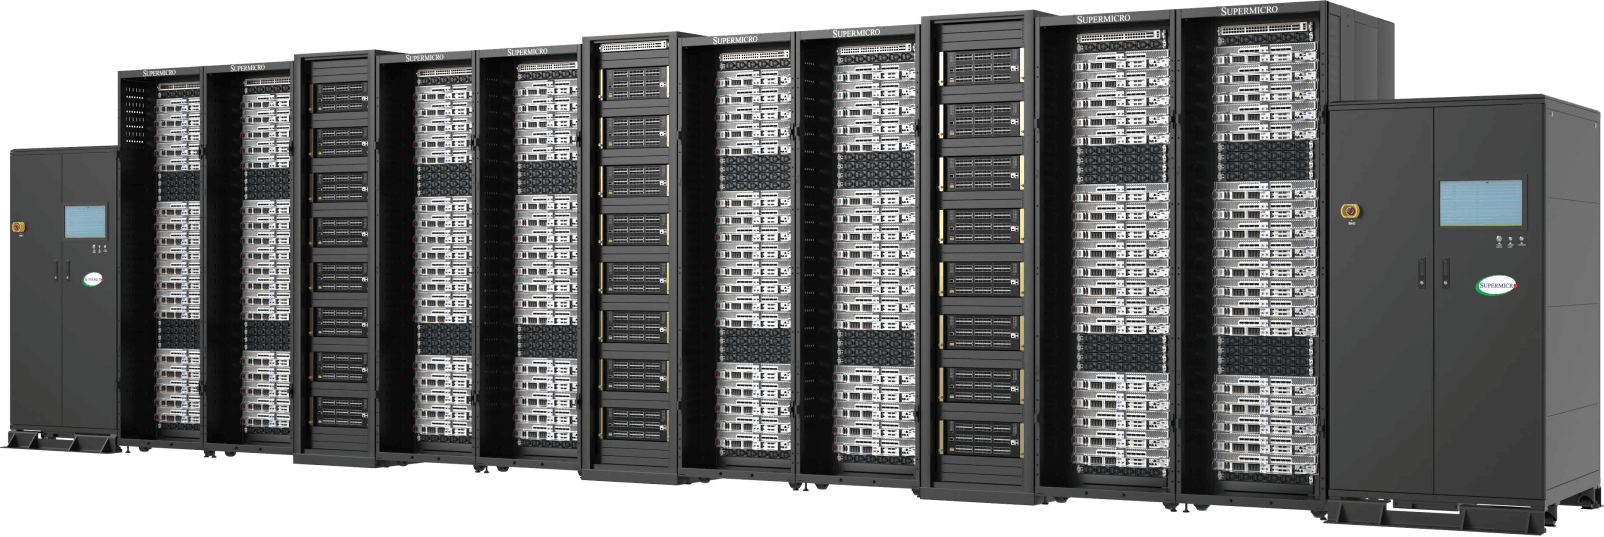
液冷式 4U NVIDIA HGX B300 AI Cluster
完全整合的液冷式 72 節點叢集,最高支援 576 個 NVIDIA B300 GPU
- 部署針對運算密度與可維護性最佳化的 NVIDIA HGX B300,以實現高效能 AI 訓練與推論
- Supermicro 採用直接液冷設計,可實現持續高功率運作並提高能源效率。
- 具備龐大的 HBM3e GPU 記憶體容量(每個 GPU 配備 288GB* HBM3e 記憶體)與系統記憶體容量,適用於基礎模型訓練
- 透過 NVIDIA Spectrum™-X 乙太網路或 NVIDIA Quantum-X800 InfiniBand 進行規模化擴充
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- 旨在全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
計算節點


氣冷式 8U NVIDIA HGX B300 AI Cluster
完全整合的氣冷式 32 節點叢集,配備高達 256 個 NVIDIA HGX B300 GPU 與總計 73.7TB 的 HBM3e 記憶體
- 基於參考架構的全端解決方案,包含 Supermicro 系統、NVIDIA GPU、NVIDIA 軟體以及 NVIDIA 網路
- 最高支援 256 個 NVIDIA HGX B300 GPU,提供高達 73.7TB 的總 HBM3e 記憶體(每個 GPU 配備 288GB HBM3e*)
- 與 NVIDIA 軟體堆疊(NVIDIA AI Enterprise 與 NVIDIA Run:ai)相容
- 隨插即用解決方案,系統已完全整合至機櫃中,並在出貨前及現場部署前完成測試
- 透過 NVIDIA Spectrum-X 乙太網路運算交換fabric或 NVIDIA Quantum-X800 InfiniBand 進行擴充;內含融合網路與頻外管理
- Supermicro AI Factory 解決方案獲得 NVIDIA 認可,支援基礎架構配置、Spectrum-X Networking 以及基於 NVIDIA Enterprise Reference Architecture for HGX B300 的軟體參考堆疊
計算節點
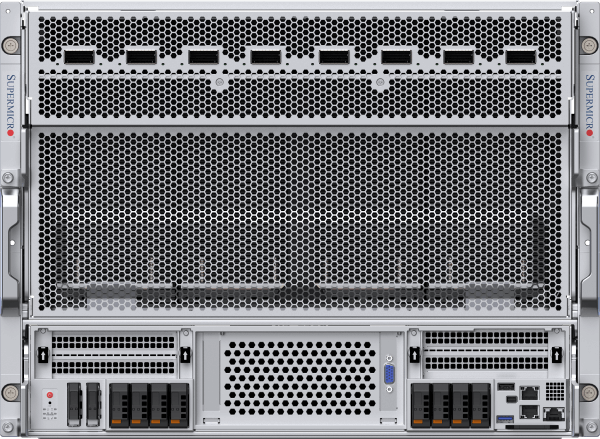

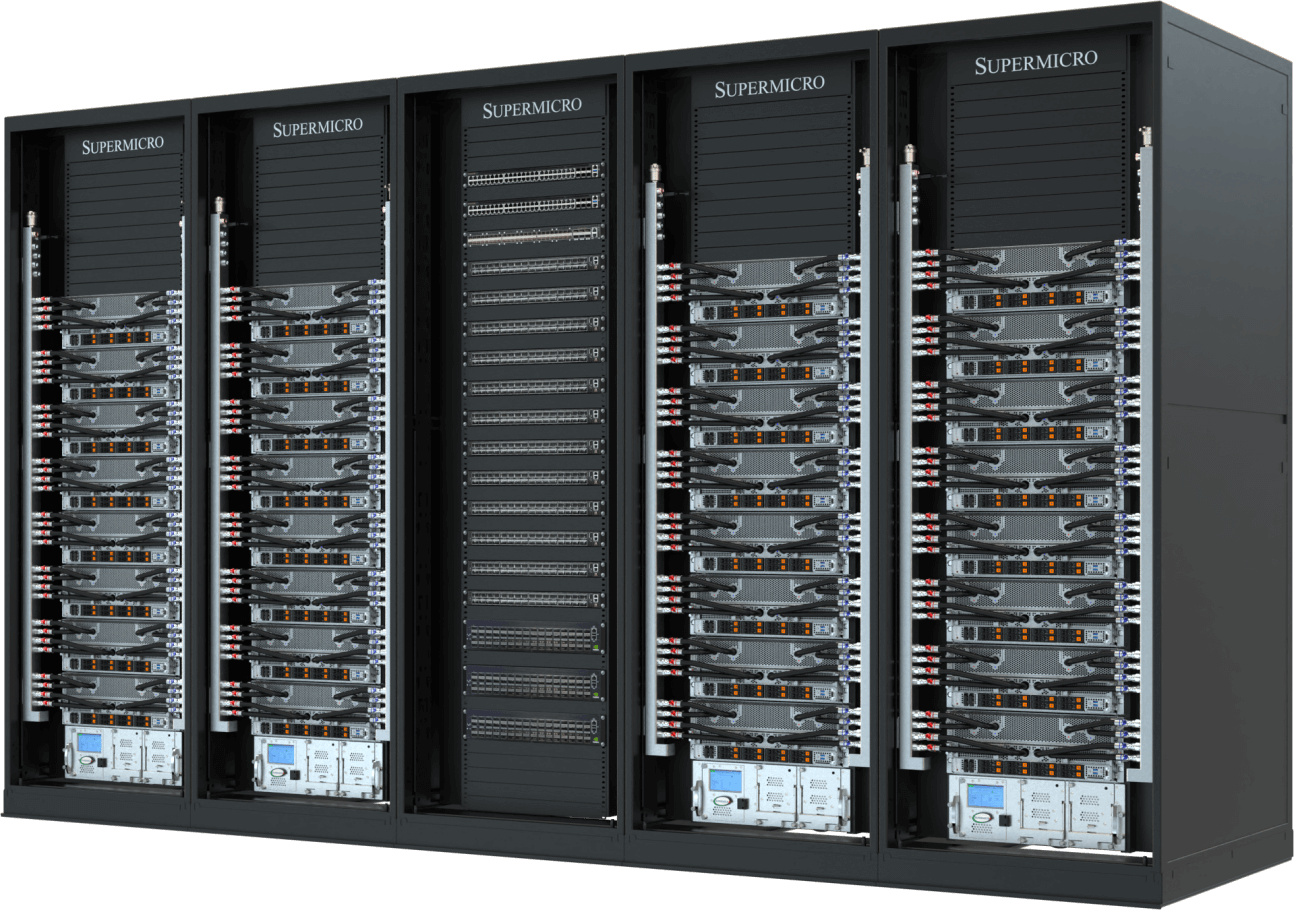
液冷式 NVIDIA HGX B200 AI Cluster
在 5 個機架中配備高達 32 個 NVIDIA HGX B200 8-GPU、4U 液冷系統(256 個 GPU)
- 在一個可擴充單元(5 個機架)中部署具備 256 個 NVIDIA B200 GPU 的頂級 AI 訓練與推論效能
- Supermicro直接液冷技術,具有可支援250kW散熱性能的機架內(In-Rack)冷卻液分配裝置(CDU),以及備援PSU和雙熱插拔幫浦
- 單一可擴充單元可支援45TB的HBM3e記憶體
- 可透過400Gb/s NVIDIASpectrum™-X乙太網路或NVIDIA Quantum-2 InfiniBand進行水平擴充
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- 旨在全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
計算節點
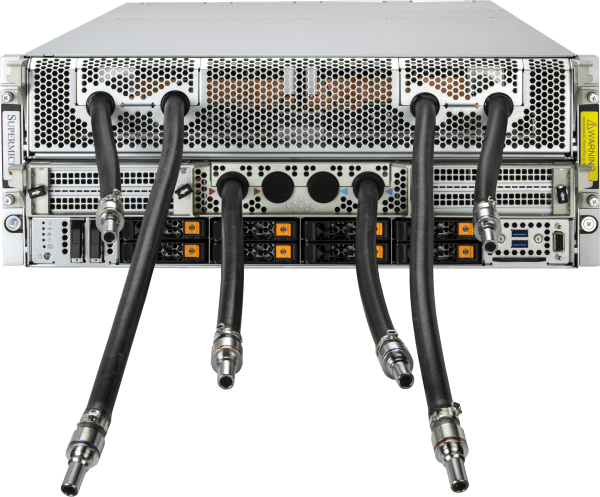
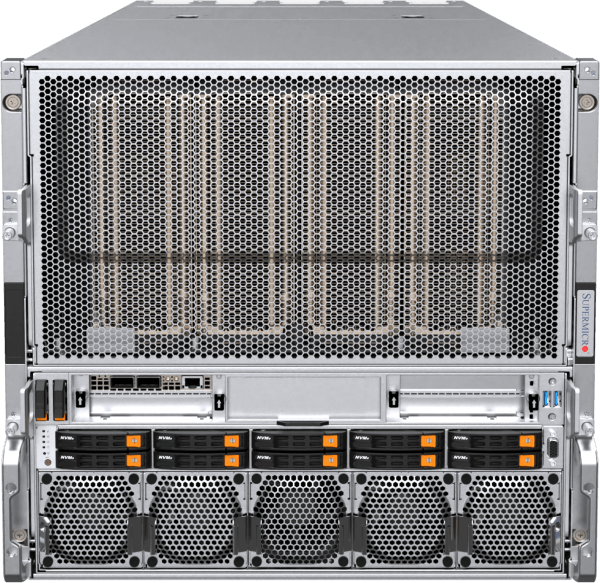
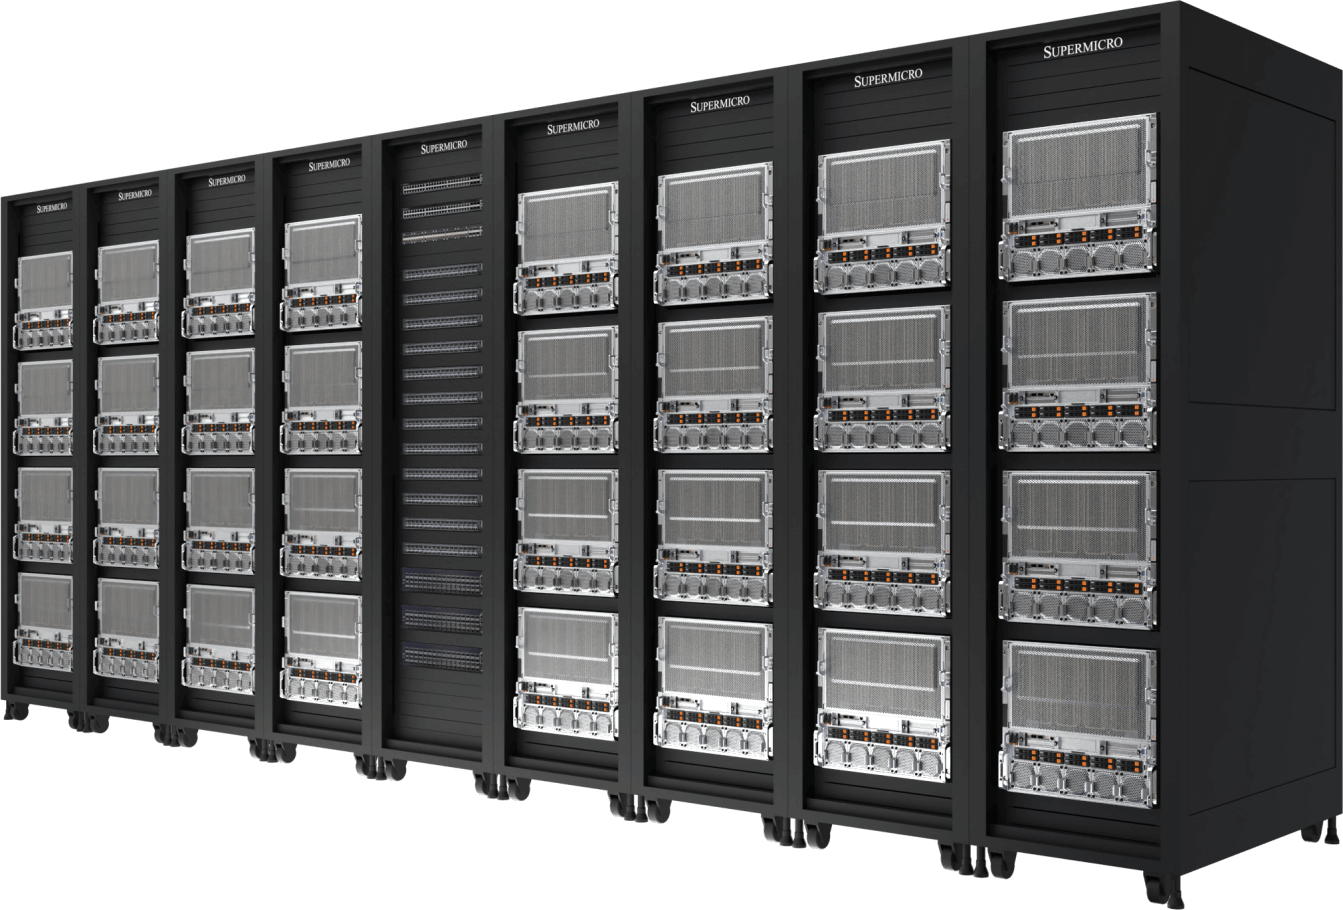
氣冷式NVIDIA HGX B200 AI Cluster
可在9組機架內配置32個NVIDIA HGX B200 8-GPU 10U氣冷式系統(256個GPU)
- 經驗證的業界領先架構,可支援全新散熱最佳化氣冷系統平台
- 單一可擴充單元可支援45TB的HBM3e記憶體
- 透過 400Gb/s NVIDIA Spectrum-X 乙太網路或 NVIDIA Quantum-2 InfiniBand 進行擴充
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- NVIDIA 認證系統節點,全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
計算節點
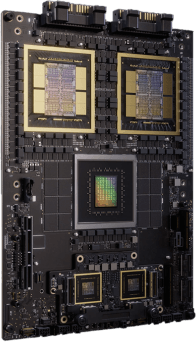
NVIDIA GB300 NVL72
單一機架內的液冷式Exascale運算系統
- 具備 NVIDIA GB300 Grace™ Blackwell Superchip 的機架級解決方案,每機架提供 72 個 NVIDIA B300 GPU 與 36 個 Grace CPU
- 配備每顆 GPU 288GB HBM3e 的 NVIDIA Blackwell Ultra
- 採用直接液冷技術,資料中心電力成本最多可降低 40%。
- 提供從諮詢到全面部署的綜合服務,包括所有必要的零件、網路解決方案和現場安裝服務。
- 透過 400Gb/s NVIDIA Spectrum-X 乙太網路或 NVIDIA Quantum-2 InfiniBand 進行擴充
- 高達 800Gb/s 的 NVIDIA Quantum-2 InfiniBand 或配備整合式 NVIDIA ConnectX®-8 SuperNICs 的 Spectrum-X 乙太網路
機架解決方案
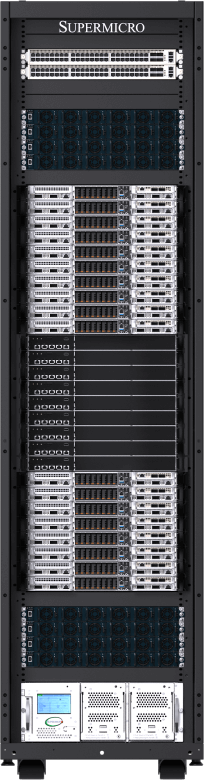
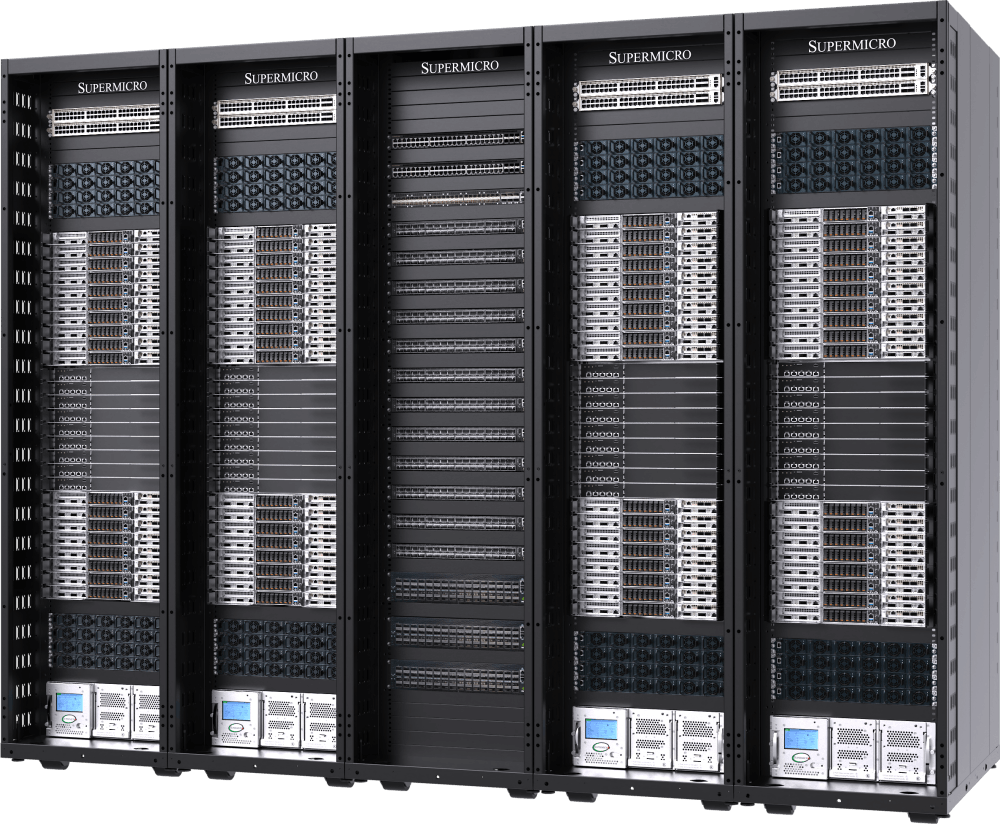
NVIDIA GB200 NVL72
單一機架內的液冷式Exascale運算系統
- 72 個 NVIDIA Blackwell B200 GPU 整合為單一 GPU,並配備龐大的 HBM3e 記憶體池(每機櫃 13.5TB)
- 9 個 NVLink Switch,每個運算匣有 4 個連接埠,連接 72 個 GPU,提供 1.8TB/s 的 GPU 對 GPU 互連頻寬
- Supermicro直接液冷技術,具有可支援250kW散熱性能的機架內(In-Rack)冷卻液分配裝置(CDU),以及備援PSU和雙熱插拔幫浦
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- 透過 400Gb/s NVIDIA Spectrum-X 乙太網路或 NVIDIA Quantum-2 InfiniBand 進行擴充
- 旨在全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
機架解決方案
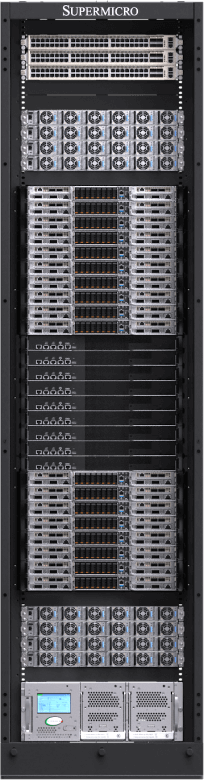
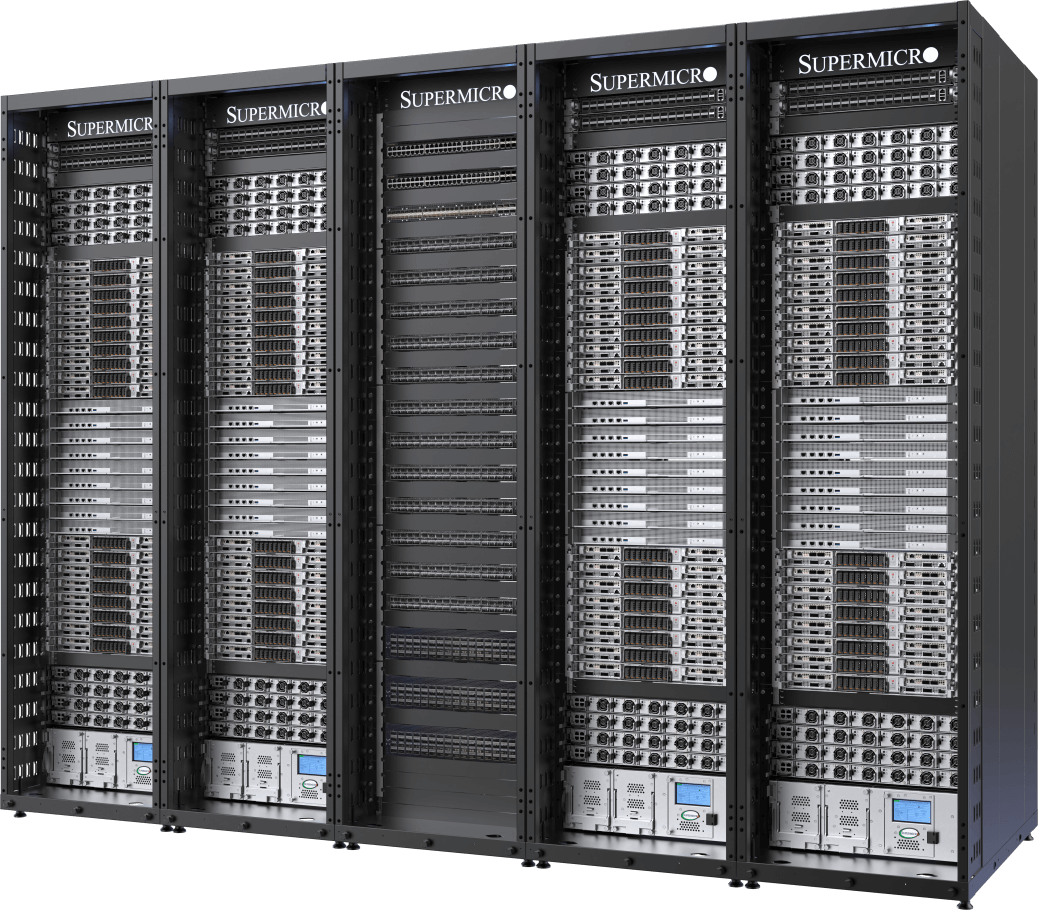
NVIDIA RTX PRO™ SuperCluster
配備 NVIDIA RTX PRO 6000 Blackwell 伺服器版本的 AI 工廠解決方案
- 基於參考架構的全端解決方案,包含 Supermicro 系統、NVIDIA GPU、NVIDIA 軟體以及 NVIDIA 網路
- 高達 256 個 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU,提供高達 24TB 的 GDDR7 記憶體
- 相容於 NVIDIA 軟體堆疊(NVIDIA AI Enterprise、NVIDIA Omniverse 與 NVIDIA Run:ai)
- 隨插即用解決方案,系統已完全整合至機櫃中,並在出貨前及現場部署前完成測試
- 包含 NVIDIA Spectrum-X 乙太網路運算架構、融合網路及頻外管理
- Supermicro AI NVIDIA 認可的工廠解決方案,涵蓋基礎設施配置、 Spectrum-X網路以及基於 NVIDIA 企業參考架構的 RTX PRO 6000 軟體參考堆疊。 Blackwell 伺服器版
計算節點
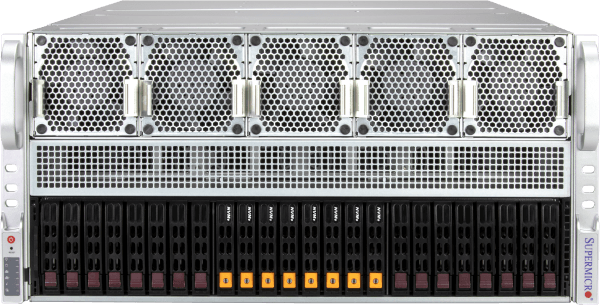

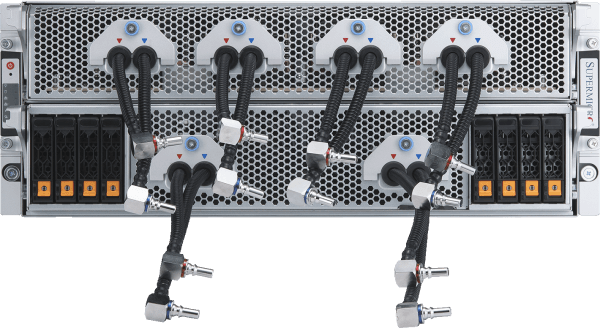
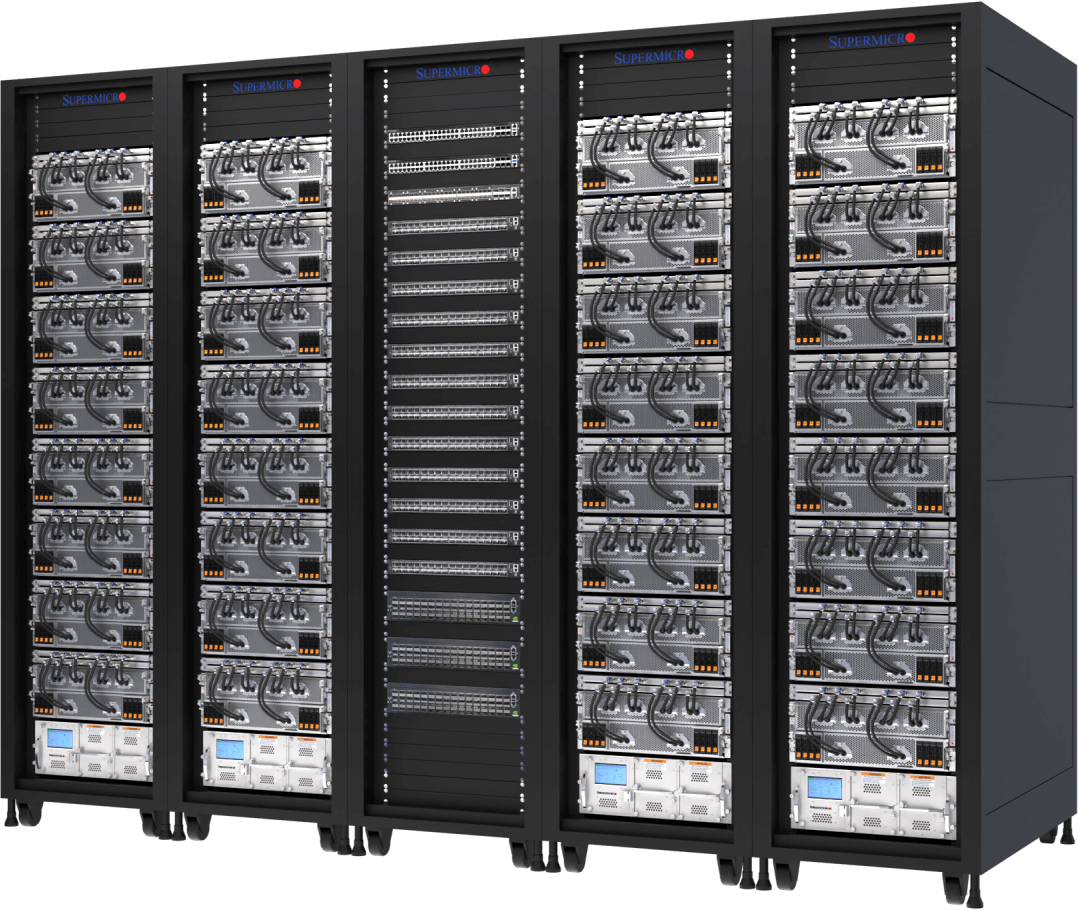
領先的液冷式AI叢集
透過 5 個機櫃中部署 32 台 NVIDIA HGX H200 8-GPU 4U 液冷系統(共 256 個 GPU)
- 透過Supermicro的客製化液冷解決方案,可將資料中心運算密度提升一倍,並降低最多40%的電力成本
- 一個可擴充單元包含 256 個 NVIDIA H200 GPU
- 36TB HBM3e 內存,採用 H200 閃存,整合於一個可擴展單元中
- 具備完整 NVIDIA GPUDirect RDMA 與 Storage 或 RoCE 支援的專用儲存網狀架構選項
- 透過 400Gb/s NVIDIA Spectrum-X 乙太網路或 NVIDIA Quantum-2 InfiniBand 進行擴充
- NVIDIA 認證系統節點,全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
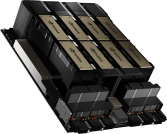
計算節點
經認證的設計
在9 個機架中配備 32 個 NVIDIA HGX H200 8-GPU、8U 氣冷系統(256 個 GPU)
- 經認證的業界領先架構,適用於大規模AI基礎設施部署
- 一個可擴充單元包含 256 個 NVIDIA H200 GPU
- 36TB HBM3e 內存,採用 H200 閃存,整合於一個可擴展單元中
- 透過 400Gb/s NVIDIA Spectrum-X 乙太網路或 NVIDIA Quantum-2 InfiniBand 進行擴充
- 可客製化的AI資料管道儲存結構,提供業界領先的平行式檔案系統配置
- NVIDIA 認證系統節點,全面支援 NVIDIA AI 軟體平台,包含 NVIDIA AI Enterprise 與 NVIDIA Run:ai
計算節點